AI 에이전트가 만들어 준 대시보드 검증 어떻게 할까?
요즘에 AI 에이전트를 이용해 데이터를 분석하고, 심지어는 대시보드까지 한번에 빠르게 만든다. 데이터 분석가 역할이 바뀌고 있다는 얘기가 들린다. 그런데 AI 에이전트가 만들어 준 대시보드 검증 어떻게 할 지가 궁금했다. 이번 블로그에서는 내가 생각하는 검증 방법에 대해서 이야기해 보자
AI 에이전트가 다 만들어 주는 대시보드
예전에 데이터 분석 단기 코스를 다닌 적이 있는데, 그 때는 데이터 정제, 가공 부터 해서 대시보드를 만드는 것 까지 모두 나 혼자 했었다.
완벽하게 정제를 하지 못해, 몇 번이나 파이썬 코드로 돌아가고 Power BI에서 또 다시 정제를 하곤 했었다. 그 때의 기억은 생각보다 데이터 정제, 가공 심지어는 대시보드 구축까지 완전 노가다에 가깝다는 생각이 들었다.
우리 Tutor도 실제로 데이터 분석 총 순환 과정에서 데이터 정제 및 가공이 시간 대부분을 잡아 먹는다고 했다.
그런데, 지금은 이 모든 작업을 AI가 대신해 주고 있다. 속도도 빠르고, 보여지는 대시보드의 구성, 디자인도 내가 일일이 수작업으로 했던 것 보다 훨씬 낫다.
하지만, 이 AI 에이전트가 만들어 준 대시보드 검증을 어떻게 할 수 있을까 하는 생각이 들었다. 만약 다른 사람에게 보고를 해야 하는 데, 그냥 AI가 이렇게 만들어 줬습니다. 라고 말을 할 수는 없지 않은가!
나의 대시보드 검증 방법
특별한 대시보드 검증 방법을 나는 모른다. 내가 아는 것은 AI가 사용했던 코드를 확인하는 것 뿐이다.
간단한 KPI 핵심 지표는 SQL 쿼리를 이용해서 데이터 값을 출력해서 확인할 수 있었다. 문제는 코호트 클래식 리텐션 같은 것은 데이터리안 데이터 분석 캠프에서 배웠음에도 쉽사리 쿼리가 짜지지 않았다.
그래서 AI에게 사용한 쿼리를 가져와 달라고 요청했다. 내 생각에 AI 에이전트 대시보드 구축할 때도 쿼리를 만들 때도 파이썬 코드를 사용한 것 같았지만, 나는 SQL 쿼리로 결과값을 확인해 보고 싶어서 SQL 쿼리를 요구했다.
WITH user_cohort AS (
    SELECT
        user_id,
        DATE(MIN(STR_TO_DATE(event_time, '%d/%m/%Y %H:%i:%s'))) AS signup_date
    FROM passorder_event_log
    WHERE ab_test_group = 'Group A (Control)'
      AND event_time IS NOT NULL
    GROUP BY user_id
),
cohort_size AS (
    SELECT
        COUNT(DISTINCT user_id) AS total_users
    FROM user_cohort
),
weekly_activity AS (
    SELECT
        e.user_id,
        FLOOR(DATEDIFF(DATE(STR_TO_DATE(e.event_time, '%d/%m/%Y %H:%i:%s')), c.signup_date) / 7) AS week_num
    FROM passorder_event_log e
    INNER JOIN user_cohort c
        ON e.user_id = c.user_id
    WHERE e.ab_test_group = 'Group A (Control)'
      AND e.event_time IS NOT NULL
      AND DATEDIFF(DATE(STR_TO_DATE(e.event_time, '%d/%m/%Y %H:%i:%s')), c.signup_date) BETWEEN 0 AND 89
    GROUP BY e.user_id, week_num
)
SELECT
    CONCAT('W', a.week_num) AS week,
    COUNT(DISTINCT a.user_id) AS active_users,
    cs.total_users AS cohort_users,
    ROUND(COUNT(DISTINCT a.user_id) * 100.0 / cs.total_users, 1) AS retention_rate_pct
FROM weekly_activity a
CROSS JOIN cohort_size cs
WHERE a.week_num BETWEEN 0 AND 12
GROUP BY a.week_num, cs.total_users
ORDER BY a.week_num;
패스오더 교차 브랜드 적립 허용 여부에 대한 A/B 테스트
내가 대시보드 검증을 하고 있는 이 프로젝트는 커피 및 디저트 주문 앱인 패스오더에 교차 브랜드 적립을 허용한 경우와 아닌 경우의 A/B 테스트 결과를 대시보드로 보여주는 것이었다.
프로젝트 설명에 원하시는 분들은 아래 포스팅에서 확인할 수 있다.
SQL 쿼리 이해하기
첫번째 테이블, 각 유저별로 최초 가입일 구하기
SELECT
        user_id,
        DATE(MIN(event_time)) AS signup_date
    FROM passorder_events_log
    WHERE ab_test_group = 'Group A (Control)'
    GROUP BY user_id
데이터를 불러올 때, 내가 어떤 DBMS를 사용하고 있는 지를 생각해 봐야 한다. 나는 MySQL를 사용하는 데, 데이터 불러올 때 특별한 요청을 하지 않았다.
아래 이미지는 Dberver에서 MySQL 서버와 연결해서 쿼리를 짜고 실행 시킨 장면이다.
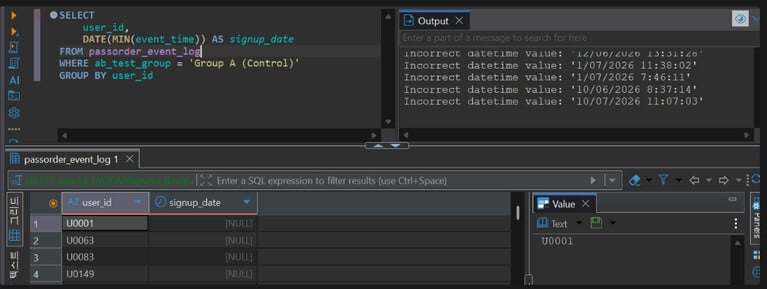
MySQL에서는 every_time 컬럼의 날짜 형식을 읽지를 못해서 그냥 문자열으로 처리해 버렸다. 그러다 보니 signup_date 컬럼이 모두 결측값(Null)으로 나와 버렸다.
이번 일을 겪고 나니, 데이터 가져올 때 데이터 타입에 대해서도 먼저 체크를 하는게 좋겠구나 하는 생각이 들었다. 처음에 위와 같이 나왔을 때 완전 어이가 없었다.
이 문제를 해결하기 위해 문자열을 날짜 형식으로 변경하는 STR_TO_DATE 함수를 아래와 같이 사용했다.
SELECT
        user_id,
        DATE(MIN(STR_TO_DATE(event_time, '%d/%m/%Y %H:%i:%s'))) AS signup_date
    FROM passorder_event_log
    WHERE ab_test_group = 'Group A (Control)'
      AND event_time IS NOT NULL
    GROUP BY user_id
위 DATE 쿼리 부분이 제일 중요한 부분이다. 문자열을 날짜 형식으로 바꾸고, MIN 함수를 이용해서 가장 빠른(이른) 날짜를 원했다. 그리고 시분초는 필요가 없어서 DATE 함수로 년월일만 출력하게 만들었고, 결과는 아래와 같다.
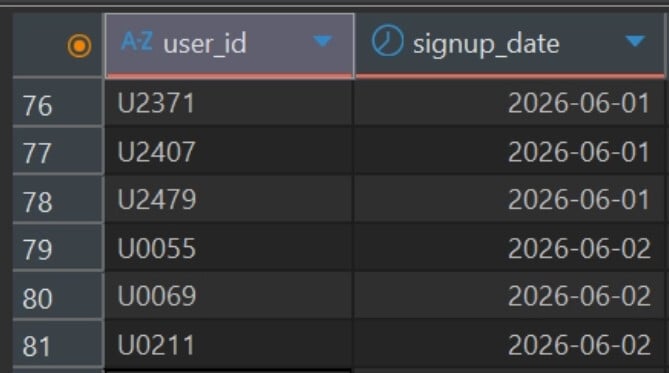
이 부분은 각 사용자가 이 패스오더 앱에 제일 처음 들어온 날짜를 의미한다. 첫 전체 쿼리 중에 첫번째 테이블에서는 각 유저별로 최초 가입일을 구한 것이다.
두번째 전체 사용자 수 확인 쿼리
두번째에서는 나중에 비율을 구하기 위해 코호트 별 전체 사용자 수(1250)를 구하는 쿼리이다. 이 전체 쿼리는 With절으로 필요한 테이블 쿼리를 작성하였다.
WITH user_cohort AS (
    -- 1. 유저별 최초 유입일(Cohort 기준일) 정의
    SELECT
        user_id,
        DATE(MIN(STR_TO_DATE(event_time, '%d/%m/%Y %H:%i:%s'))) AS signup_date
    FROM passorder_event_log
    WHERE ab_test_group = 'Group A (Control)'
      AND event_time IS NOT NULL
    GROUP BY user_id
)
    SELECT
        COUNT(DISTINCT user_id) AS total_users
    FROM user_cohort
세번째 이 유저는 몇 번째 주에 방문하는가 쿼리
여기서 구하고자 하는 것은 유저 아이디와 몇 번째 주에 방문했는 지를 알아보는 것이다. 출력 컬럼은 e.user_id, week_num이다
” 이 유저가 몇 번째 중에 방문 했는 지를 어떻게 구하지가 궁금했다 ” 왜냐하면 주간 클래식 리텐션에서 방문했던 모든 주를 알아야 하기 때문이다.
핵심 빨간 쿼리는 문자열을 날짜 형식으로 바꾸고, 연월일만 가져와서, 그것과 최초 가입일의 경과일 수(DATEDIFF) 구한 후 그것을 7로 나누고, 나머지가 있으면 버려라 라는 것이다. (아래 조인된 테이블을 보시면 이해하기 쉽다)
SELECT e.user_id
     , FLOOR(DATEDIFF(DATE(STR_TO_DATE(e.event_time, '%d/%m/%Y %H:%i:%s')), c.signup_date) / 7) AS week_num
FROM passorder_event_log as e
    INNER JOIN user_cohort c ON e.user_id = c.user_id --전체 user_id랑 그룹바이 user_id
WHERE e.ab_test_group = 'Group A (Control)'
  AND e.event_time IS NOT NULL
   -- 유입일로부터 90일(0~89일) 내 이벤트만 대상
  AND DATEDIFF(DATE(STR_TO_DATE(e.event_time, '%d/%m/%Y %H:%i:%s')), c.signup_date) BETWEEN 0 AND 89
    GROUP BY e.user_id, week_num
원본 데이터(passorder_event_log)를 기준으로 user_cohort(유저 아이디 group by, 최초 가입일)와 Inner Join을 한다.
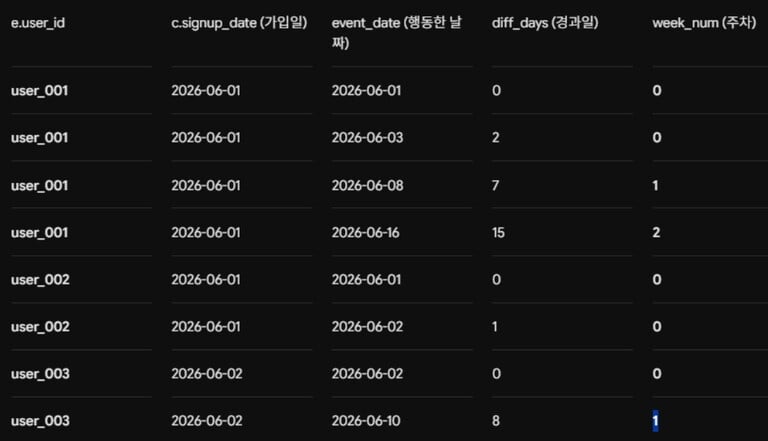
Inner join을 하는 이유는 각 유저별 방문한 날의 기록과 최초 가입일을 알면, 몇 주차에 재방문을 했는데 알 수 있다.
예를 들어 user_001은 최초 가입일이 6월 1일이고, 6월 8일, 6월 16일에 각각 재방문을 하였다. 각각 최초 가입일로 부터 경과일은 7일과 15일이 나온다.
1일은 0주차라고 생각하면, 8일은 그 다음 주인 1주차에 재방문한 것이고, 16일은 15일이 지났으니, 2주차에 또 방문을 한 것을 알 수 있다.
그럼 user_001은 0주차, 1주차, 2주차까지 리텐션이 유지되었다는 것을 의미한다.
Where 조건절에서 경과일 수를 0부터 89로 정한 이유는 이 데이터의 기간이 3개월 즉 90일 밖에 없다. 당일은 0으로 시작하면 90일은 89가 된다.
네번째 A군 총 쿼리
WITH user_cohort AS (
    SELECT
        user_id,
        DATE(MIN(STR_TO_DATE(event_time, '%d/%m/%Y %H:%i:%s'))) AS signup_date
    FROM passorder_event_log
    WHERE ab_test_group = 'Group A (Control)'
      AND event_time IS NOT NULL
    GROUP BY user_id
),
cohort_size AS (
    SELECT
        COUNT(DISTINCT user_id) AS total_users
    FROM user_cohort
),
weekly_activity AS (
    SELECT
        e.user_id,
        FLOOR(DATEDIFF(DATE(STR_TO_DATE(e.event_time, '%d/%m/%Y %H:%i:%s')), c.signup_date) / 7) AS week_num
    FROM passorder_event_log e
    INNER JOIN user_cohort c
        ON e.user_id = c.user_id
    WHERE e.ab_test_group = 'Group A (Control)'
      AND e.event_time IS NOT NULL
      AND DATEDIFF(DATE(STR_TO_DATE(e.event_time, '%d/%m/%Y %H:%i:%s')), c.signup_date) BETWEEN 0 AND 89
    GROUP BY e.user_id, week_num
)
SELECT
    CONCAT('W', a.week_num) AS week,
    COUNT(DISTINCT a.user_id) AS active_users,
    cs.total_users AS cohort_users,
    ROUND(COUNT(DISTINCT a.user_id) * 100.0 / cs.total_users, 1) AS retention_rate_pct
FROM weekly_activity a
CROSS JOIN cohort_size cs
WHERE a.week_num BETWEEN 0 AND 12
GROUP BY a.week_num, cs.total_users
ORDER BY a.week_num;
나는 e.user_id와 a.user_id가 어떻게 다른 지를 가지고 한참을 씨름했었다. 결국 우리가 알아보고자 한 데이터는 어떤 유저가 몇주, 몇주, 몇주에 방문을 했는지 이이지만, e.user_id는 원본 데이터로 방문한 족족 모든 기록이 남겨져 있다.
세번째 테이블에서 e.user_id와 week_num을 Group by로 함께 그룹화하였다. 원래 위와 같이 나오던 테이블이 Group by 때문에 아래와 같이 출력이 된다
이것이 우리가 클래식 리텐션 비율을 구하기 위한 컬럼이다. 바로 어떤 유저가 몇번째 주, 몇 번째 주에 재방문하였는가 이다. 바로 아래가 a.user_id 형태이다.
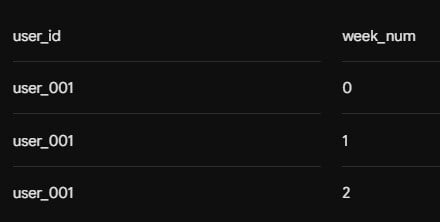
그리고 마지막에 a.week_num으로 Group by를 하기 때문에 0주차에 있는 a.user_id를 카운트해서 총 몇 명인지 확인할 수 있다. 그 숫자들은 주가 갈 수록 일반적으로 감소하는 데 아래 결과 표에서 확인할 수 있다.
마지막 부분의 쿼리가 바로 우리가 원하는 A군의 리텐션 코드이다. 총 4개의 컬럼으로 week, active_users, cohort_users, retention_rate_pct를 출력해 달라고 했다.
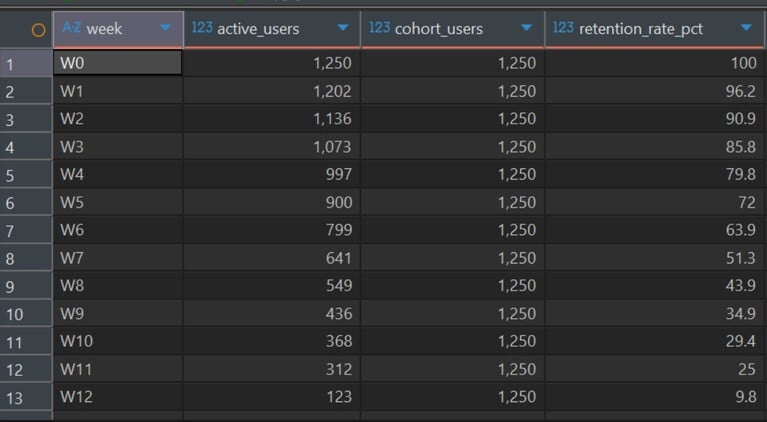
- week : CONCAT(‘W’, a.week_num)
- active_users : COUNT(DISTINCT a.user_id)
- cohort_users : cs.total_users
- retention_rate_pct : (active_users / cohort_users) * 100
위의 A군의 쿼리를 정리해 보았다. B군도 A군과 크게 다르지 않다. 지금까지 A군의 리텐션을 구해 본 것은 어떤 식으로 쿼리가 짜여져 있는지 알아보기 위한 것이었다.
실제로 대시보드에 그려진 그래프는 이것이다. A군과 B군이 함께 있는 것이다.
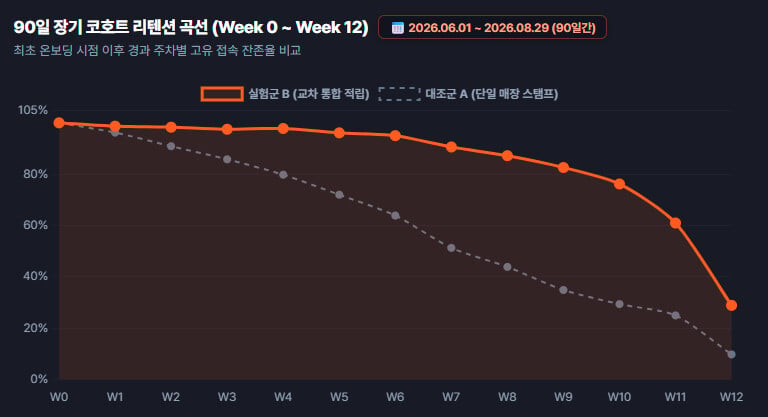
대시보드 검증을 위해서는 아래 쿼리를 이해를 해야 한다
WITH user_cohort AS (
    SELECT
        user_id,
        ab_test_group,
        DATE(MIN(STR_TO_DATE(event_time, '%d/%m/%Y %T'))) AS signup_date
    FROM passorder_event_log
    WHERE ab_test_group IN ('Group A (Control)', 'Group B (Treatment)')
      AND event_time IS NOT NULL
      AND event_time != ''
    GROUP BY user_id, ab_test_group
),
cohort_sizes AS (
    SELECT
        ab_test_group,
        COUNT(DISTINCT user_id) AS total_users
    FROM user_cohort
    GROUP BY ab_test_group
),
weekly_activity AS (
    SELECT
        c.ab_test_group,
        e.user_id,
        FLOOR(DATEDIFF(DATE(STR_TO_DATE(e.event_time, '%d/%m/%Y %T')), c.signup_date) / 7) AS week_num
    FROM passorder_event_log e
    INNER JOIN user_cohort c
        ON e.user_id = c.user_id
    WHERE e.ab_test_group IN ('Group A (Control)', 'Group B (Treatment)')
      AND e.event_time IS NOT NULL
      AND e.event_time != ''
      AND DATEDIFF(DATE(STR_TO_DATE(e.event_time, '%d/%m/%Y %T')), c.signup_date) BETWEEN 0 AND 89
    GROUP BY c.ab_test_group, e.user_id, week_num
)
SELECT
    CONCAT('W', w.week_num) AS week,
    ROUND(COUNT(DISTINCT CASE WHEN w.ab_test_group = 'Group A (Control)' THEN w.user_id END) * 100.0
          / MAX(CASE WHEN cs.ab_test_group = 'Group A (Control)' THEN cs.total_users END), 1) AS retention_a_pct,
    ROUND(COUNT(DISTINCT CASE WHEN w.ab_test_group = 'Group B (Treatment)' THEN w.user_id END) * 100.0
          / MAX(CASE WHEN cs.ab_test_group = 'Group B (Treatment)' THEN cs.total_users END), 1) AS retention_b_pct,
    ROUND(
        (COUNT(DISTINCT CASE WHEN w.ab_test_group = 'Group B (Treatment)' THEN w.user_id END) * 100.0
         / MAX(CASE WHEN cs.ab_test_group = 'Group B (Treatment)' THEN cs.total_users END))
        -
        (COUNT(DISTINCT CASE WHEN w.ab_test_group = 'Group A (Control)' THEN w.user_id END) * 100.0
         / MAX(CASE WHEN cs.ab_test_group = 'Group A (Control)' THEN cs.total_users END))
    , 1) AS diff_pct_point
FROM weekly_activity w
CROSS JOIN cohort_sizes cs
WHERE w.week_num BETWEEN 0 AND 12
GROUP BY w.week_num
ORDER BY w.week_num;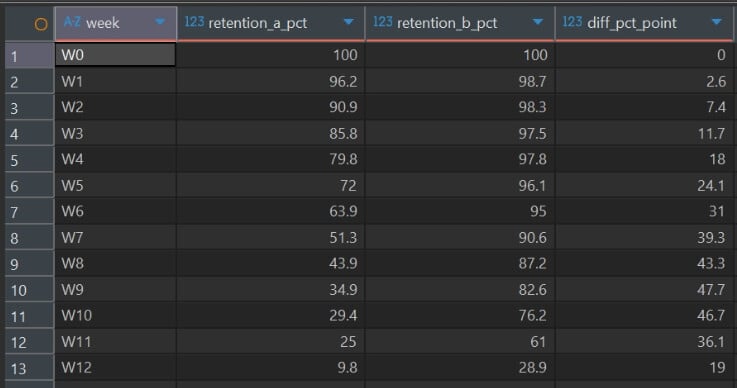
위의 쿼리는 차트를 그려낼 수 있게 도와주는 쿼리다. A군과 B군의 리텐션 %를 출력하고 그 차이가 얼마나 나는 지를 결과 값으로 알 수 있다.
차트의 2개의 선의 간격이 바로 차이 나는 값이다. 차이 값을 봤을 때 W8, W9, W10의 차이가 가장 큰 것을 알 수 있다.
마무리
오늘은 AI 에이전트가 생성한 대시보드 검증을 어떻게 하는 지에 대해서 이야기해 보았다. AI가 다 해주는 데, 굳이 프로그래밍을 해야 해 하는 생각이 완전히 박살 났다.
AI가 해 주는 것을 다 믿을 수 있을까? 라는 질문에 100% 확신이 없다면, 데이터 분석가로서, 그가 생성한 대시보드 검증할 수 있는 능력이 키워야 한다고 생각한다.
위의 SQL 쿼리는 그다지 복잡하지 않았음에도 불구하고, 이해를 하는 데 큰 어려움을 겪었다. 아마 그 쿼리를 직접 작성해 보라고 했으면 하지 못했을 것 같다.
SQL로 위의 쿼리를 100% 확실하게 짜진 못하더라도, 큰 어려움 없이 이해할 수 있는 실력 까지 라도 가고 싶다.